Cara Mengelola Kuota Menit Transkripsi agar Produksi Konten Tetap Hemat
Creator Workflow · 2026-09-13 · 9 menit baca · Tim Editorial Podlyzer
Mengunggah rekaman mentah secara membabi buta menguras anggaran AI Anda. Terapkan strategi praktis mengelola kuota menit transkripsi agar alur kerja produksi konten tetap efisien dan ramah biaya.
Bagi sebagian besar tim produksi media dan kreator independen, biaya langganan platform kecerdasan buatan sering kali membengkak bukan karena frekuensi publikasi yang tinggi, melainkan akibat pemborosan unit konsumsi paling fundamental: kuota menit transkripsi. Model komputasi Automatic Speech Recognition (ASR) membebankan biaya berdasarkan setiap detik audio yang diproses oleh server, tanpa memedulikan apakah detik tersebut memuat wawasan berharga atau sekadar jeda hening selama sepuluh detik. Memperlakukan kuota transkripsi layaknya ruang penyimpanan awan tanpa batas adalah kekeliruan finansial yang kerap menggerus profitabilitas studio produksi konten.
Ketika sebuah tim mengunggah rekaman mentah berdurasi sembilan puluh menit untuk episode wawancara yang sebenarnya hanya membutuhkan rangkuman tiga puluh menit, mereka telah membuang dua pertiga dari alokasi sumber daya mereka. Pengelolaan kuota menit transkripsi yang disiplin bukan sekadar persoalan menekan pengeluaran bulanan, melainkan tentang membangun higienitas alur kerja yang melipatgandakan output konten turunan dari setiap menit audio yang diproses.
Jebakan Rekaman Mentah: Mengapa Pendekatan Konvensional Menguras Anggaran
Pendekatan konvensional yang umum dilakukan oleh tim produksi adalah pola unggah semua lalu edit kemudian. Pola ini mengasumsikan bahwa menyerahkan seluruh file mentah berdurasi panjang ke mesin transkripsi AI akan menghemat waktu pra-produksi. Pada kenyataannya, kebiasaan ini menimbulkan tiga kebocoran operasional yang masif:
- Pemborosan Biaya pada Obrolan Pemanasan (Warm-Up Banter): Sesi rekaman podcast profesional umumnya dimulai dengan lima hingga lima belas menit percakapan santai, pengecekan level mikrofon, dan sinkronisasi teknis. Mentranskripsi bagian ini berarti membayar tagihan komputasi untuk percakapan yang seratus persen akan dibuang di meja penyuntingan.
- Kepadatan Informasi yang Terlalu Rendah (Low Information Density): Episode podcast dengan format diskusi bebas sering kali diwarnai pengulangan ide, jeda berpikir yang panjang, tawa berkepanjangan, atau interupsi teknis. Mesin ASR menghitung durasi tersebut secara linear, sehingga Anda membayar tarif penuh untuk audio berbobot nol.
- Beban Kognitif pada Tahap Pascaproduksi: Teks transkripsi mentah yang mencapai puluhan ribu kata justru menyulitkan tim konten dalam memilah kutipan kunci. Naskah yang terlalu panjang dan berantakan memperlambat proses prompting ke model bahasa besar (LLM), meningkatkan konsumsi token, dan sering kali menghasilkan draf ringkasan yang melebar tanpa fokus tajam.
Ketiadaan filter selektif pada tahap awal produksi menyebabkan kuota menit transkripsi cepat habis di awal siklus penagihan, memaksa kreator melakukan pembelian kuota tambahan dengan tarif per menit yang jauh lebih mahal.
Kerangka Kerja Selective Ingestion: Memaksimalkan Nilai Setiap Detik Audio
Untuk menghentikan kebocoran kuota, Anda memerlukan sistem penyaringan sistematis sebelum berkas audio menyentuh server pemrosesan AI. Kami menerapkan kerangka kerja Selective Ingestion Framework yang membagi proses kurasi audio menjadi tiga pilar utama:
1. Pruning (Pemangkasan Durasi Mati)
Pruning berfokus pada penghapusan segmen audio yang secara definitif tidak akan dipublikasikan. Ini mencakup penghapusan buffer sepuluh menit sebelum wawancara resmi dimulai, jeda istirahat di tengah rekaman, dan penutup informal setelah naskah formal berakhir. Dengan memangkas durasi mati sebelum proses unggah, Anda dapat menghemat antara 15 hingga 25 persen kuota menit transkripsi pada setiap sesi produksi.
2. Triage Kerapatan Wawasan (Value-Density Mapping)
Tidak semua bagian dari sebuah rekaman satu jam layak ditranskripsikan ke dalam bentuk teks untuk dijadikan aset tulisan. Melalui pemetaan nilai, produser menandai stempel waktu di mana narasumber menyampaikan kerangka kerja konseptual, studi kasus, atau data analitis. Bagian transisi naratif yang panjang atau anekdot pribadi yang tidak relevan dengan topik utama dapat dikecualikan dari proses transkripsi AI, menyisakan segmen berbobot tinggi yang siap dikonversi menjadi artikel atau postingan media sosial.
3. Audio Normalization dan Channel Stripping
Kualitas file yang diunggah secara langsung mempengaruhi efisiensi deteksi ASR. Rekaman stereo dua kanal yang tidak dikonsolidasikan dapat memicu pemrosesan redundan pada algoritma transkripsi tertentu. Mengonversi audio menjadi mono dan menerapkan filter noise gate sederhana di stasiun kerja audio digital memastikan algoritma tidak membuang resource pemrosesan pada derau latar belakang atau kebocoran mikrofon antar-pembicara.
Panduan Langkah Demi Langkah Mengoptimalkan Kuota Menit Transkripsi
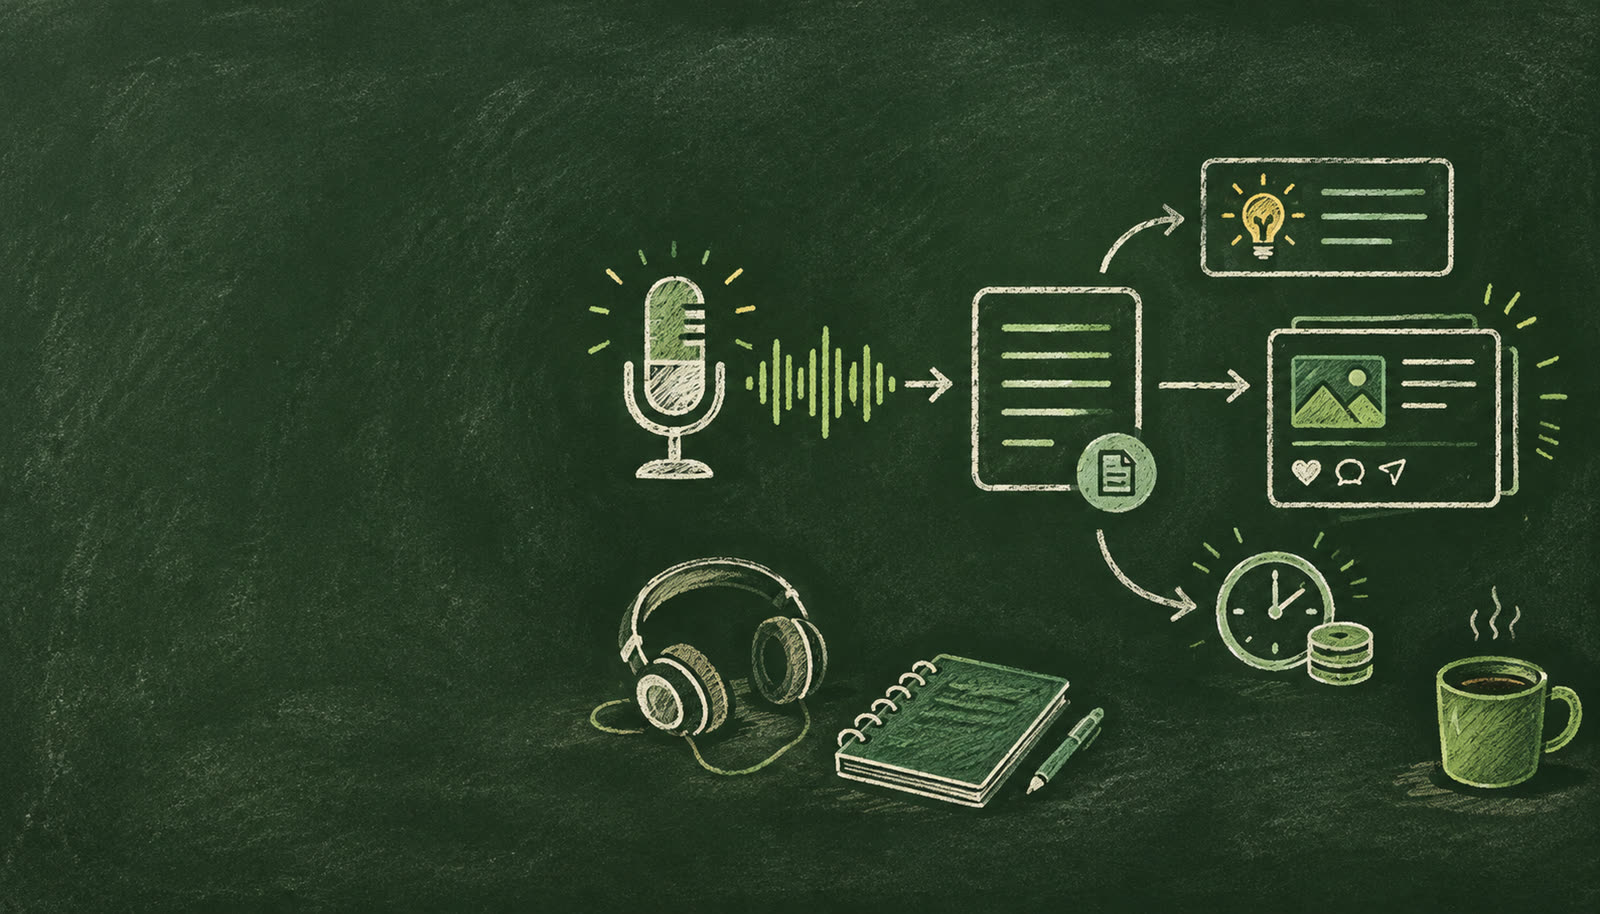
Implementasi strategi penghematan kuota tidak menuntut perombakan radikal pada jadwal rekaman Anda. Cukup terapkan alur kerja empat langkah terstruktur berikut pada setiap batch rekaman:
Langkah 1: Eksekusi Rough Cut Otomatis di DAW Lokal
Sebelum berkas audio diekspor dari perangkat lunak rekaman seperti Reaper, Audacity, atau Adobe Audition, manfaatkan fitur pemotong hening otomatis (Silence Removal atau Strip Silence). Fitur ini secara instan memangkas jeda hening di atas dua detik yang kerap terjadi saat narasumber berpikir atau meminum air. Pada rekaman podcast santai berdurasi enam puluh menit, teknik pemangkasan jeda hening ini terbukti mampu memotong durasi total berkisar antara enam hingga sepuluh menit tanpa menghilangkan sepatah kata pun.
Langkah 2: Pisahkan Rekaman Berdasarkan Kluster Topik
Hindari mengunggah satu file raksasa berdurasi dua jam jika episode Anda membahas tiga topik yang berbeda. Potong berkas audio menjadi tiga file terpisah berdasarkan segmen topik pembahasan. Strategi modular ini memberikan fleksibilitas: Anda dapat langsung mentranskripsi segmen topik pertama yang paling mendesak untuk jadwal rilis minggu ini, sambil menunda pemrosesan dua segmen lainnya hingga alokasi kuota bulan berikutnya diperbarui jika batas kuota bulanan Anda hampir tercapai.
Langkah 3: Isolasi Trek Pembicara Tunggal untuk Segmentasi Spesifik
Jika Anda memproduksi podcast wawancara di mana tujuan utamanya adalah mengekstraksi wawasan milik sang tamu ahli, pertimbangkan untuk hanya mentranskripsikan trek audio milik narasumber. Pertanyaan host yang panjang sering kali menghabiskan porsi 30 hingga 40 persen durasi audio. Dengan hanya mengunggah trek suara narasumber, Anda memotong konsumsi kuota menit transkripsi hingga hampir separuh, sembari tetap memperoleh intisari jawaban terbaik untuk diolah menjadi thread media sosial atau kutipan carousel.
Langkah 4: Terapkan Protokol Standarisasi Format Berkas
Pastikan audio diekspor dalam format terkompresi berkualitas tinggi yang ramah mesin pencari dan ASR, seperti MP3 atau AAC dengan bit rate 96 hingga 128 kbps mono. Hindari mengunggah berkas WAV mentah nir-kompresi berukuran multi-gigabyte. Meskipun ukuran berkas gigabyte tidak memengaruhi kuota menit, proses unggah yang berat sering kali menyebabkan timeout atau kegagalan pemrosesan yang memaksa pengguna mengulang proses transkripsi, yang pada sistem tertentu berisiko memicu pemotongan kuota ganda.
Matriks Keputusan: Audit Kelayakan Ingestion Berkas Audio
Gunakan tabel matriks keputusan berikut sebagai panduan standar operasional prosedur bagi tim konten sebelum menekan tombol unggah pada platform transkripsi:
| Tipe Segmen Audio | Karakteristik Konten | Tindakan Pra-Ingestion | Potensi Penghematan Kuota |
|---|---|---|---|
| Pemanasan & Soundcheck | Basa-basi narasumber, cek sinyal, koordinasi teknis | Hapus total sebelum rendering berkas | 10% - 15% |
| Jeda & Hening (Dead Air) | Diam saat berpikir, jeda minum, hening antar-pertanyaan | Terapkan Strip Silence di DAW | 8% - 12% |
| Anekdot Non-Topikal | Gurauan sampingan, obrolan cuaca, topik luar agenda | Lewati ekspor atau tandai stempel waktu | 15% - 20% |
| Inti Argumen & Studi Kasus | Analisis mendalam, data teknis, formula strategis | Prioritaskan transkripsi kualitas tinggi | 0% (Wajib Transkrip) |
| Outro & Basa-Basi Penutup | Ucapan terima kasih berulang, promosi media sosial pribadi | Gunakan template teks manual statis | 5% - 8% |
Penerapan disiplin pada matriks di atas secara konsisten mampu menekan konsumsi kuota menit transkripsi rata-rata sebesar 35 hingga 50 persen per episode tanpa mengurangi nilai substansi materi edukasi yang dihasilkan.
Mengoptimalkan Efisiensi Bersama Alur Kerja Terintegrasi Podlyzer
Mengelola pemotongan berkas audio dan transkripsi secara manual di berbagai perangkat lunak yang terpisah tentu berpotensi menyita waktu tim editorial. Di sinilah ekosistem terpadu seperti Podlyzer memainkan peran transformatif dalam memaksimalkan nilai investasi audio Anda.
Alih-alih sekadar menjadi mesin transkripsi konvensional, Podlyzer dirancang untuk mengekstraksi nilai komersial tertinggi dari setiap detik kuota menit transkripsi yang Anda investasikan. Melalui fitur transkripsi otomatis berbasis ASR mutakhir dan teknologi diarization pembicara yang presisi, platform ini secara akurat membedakan giliran bicara antara pemandu siniar dan narasumber. Hal ini menghilangkan kerancuan identitas pembicara dalam naskah tanpa membutuhkan koreksi manual yang melelahkan.
Keunggulan utama yang melipatgandakan nilai kuota Anda terletak pada mesin generator turunan konten miliknya. Dari satu kali pemrosesan audio berdurasi optimal, Podlyzer mampu secara otomatis menghasilkan hingga lima belas format aset konten terstruktur:
- Artikel blog berbobot SEO mendalam dengan struktur heading terstandarisasi.
- Edisi newsletter mingguan siap kirim yang padat wawasan.
- Publikasi artikel opini dan rangkuman studi kasus untuk audiens LinkedIn.
- Utas mikro-blog edukatif (thread) yang tajam untuk platform X.
- Naskah slide carousel komprehensif untuk Instagram atau LinkedIn.
- Catatan acara (show notes) lengkap dengan stempel waktu dan poin-poin penting pembahasan.
Dengan pendekatan ini, metrik efisiensi Anda berubah secara fundamental: Anda tidak lagi menghitung biaya transkripsi per menit rekaman mentah, melainkan menghitung rasio hasil aset konten per menit audio. Tiga puluh menit audio berbobot tinggi yang diproses melalui Podlyzer menghasilkan puluhan aset distribusi siap pakai, menurunkan biaya per aset konten ke level yang sangat ekonomis.
Kesimpulan dan Rangkuman Tindakan Operasional
Mengelola kuota menit transkripsi dengan bijak adalah tanda kematangan operasional sebuah tim media modern. Kuota transkripsi bukanlah pengeluaran yang harus ditakuti, melainkan inventaris berharga yang harus dikelola dengan prinsip efisiensi pabrikasi konten.
Berikut adalah daftar tindakan langsung yang dapat diterapkan oleh tim produksi Anda mulai hari ini:
- Audit Rekaman Mentah: Jangan pernah mengunggah rekaman utuh tanpa membuang segmen pemanasan dan koordinasi teknis di awal dan akhir sesi.
- Gunakan Fitur Otomatisasi DAW: Selalu jalankan fungsi penghapus jeda hening otomatis sebelum berkas audio diekspor ke format akhir.
- Fokus pada Kerapatan Nilai: Ekstrak dan transkripsikan hanya segmen audio yang memiliki bobot edukasi dan daya tarik repurposing tinggi.
- Maksimalkan Penggandaan Aset: Gandengkan hasil transkripsi berkualitas tinggi dengan platform otomatisasi seperti Podlyzer agar setiap menit kuota terkonversi menjadi 15 format aset konten multikanal.
Dengan mengalihkan fokus dari pemrosesan kuantitas durasi mentah ke kurasi kualitas audio, studio podcast Anda dapat memproduksi konten berkualitas tinggi secara konsisten, memperluas jangkauan distribusi, dan menjaga neraca operasional tetap sehat dan terukur.
Pertanyaan yang sering diajukan
Apakah memangkas jeda hening dan obrolan pemanasan sebelum transkripsi tidak membuang waktu produksi?
Tidak. Mengedit audio mentah menggunakan fitur otomatis seperti Strip Silence di DAW hanya memakan waktu satu hingga dua menit. Langkah cepat ini menghemat durasi transkripsi hingga dua puluh persen sekaligus memangkas waktu tim konten dalam membaca transkrip mentah yang penuh dengan percakapan tidak penting.
Mengapa kuota menit transkripsi dihitung berdasarkan durasi audio dan bukan jumlah kata yang diucapkan?
Mesin Automatic Speech Recognition memproses aliran data audio secara kontinu detik per detik melalui model komputasi neural. Server komputasi membutuhkan daya pemrosesan yang sama untuk menganalisis satu detik suara bising atau hening seperti halnya menganalisis satu detik ucapan cepat. Oleh karena itu, penyedia layanan selalu menggunakan metrik durasi menit.
Bagaimana cara menentukan apakah sebuah episode podcast layak ditranskripsi secara penuh atau cukup per segmen?
Gunakan prinsip kepadatan informasi: jika episode tersebut berupa wawancara naratif berkesinambungan di mana konteks saling terkait erat, transkripsi penuh setelah pemangkasan kasar sangat disarankan. Namun, jika episode berupa diskusi multi-topik atau obrolan santai, potong berkas menjadi segmen tematik dan transkripsikan hanya segmen yang memiliki nilai edukasi tinggi untuk dijadikan aset tulisan.