Cara Transkrip Video YouTube ke Teks Tanpa Subtitle: Panduan Praktis
Audio & AI · 2026-10-14 · 8 menit baca · Tim Editorial Podlyzer
Video YouTube tanpa subtitle sering kali menjadi hambatan besar bagi kreator dan profesional. Pelajari metode taktis mengubah rekaman suara menjadi dokumen teks terstruktur dengan akurasi tinggi menggunakan AI modern.
Tidak ada yang lebih menguras waktu seorang produser konten, pemasar, atau peneliti selain menemukan video wawancara berdurasi 60 menit di YouTube yang sarat wawasan, namun kreatornya tidak mengunggah subtitle sama sekali. Fitur takarir otomatis (auto-generated captions) bawaan YouTube pun sering kali tidak aktif pada video tertentu, atau jika tersedia, kualitasnya dipenuhi kata-kata rancu tanpa pembeda pembicara dan tanpa tanda baca.
Ketika tenggat waktu publikasi mendekat, mendengarkan rekaman lalu mengetik ulang perkataan pembicara kata demi kata adalah pemborosan sumber daya yang fatal. Menguasai cara transkrip video YouTube ke teks tanpa subtitle bukan lagi sekadar trik teknis individual, melainkan kapabilitas inti dalam rantai produksi media modern. Naskah teks yang akurat adalah bahan mentah esensial untuk mendongkrak visibilitas SEO, menyusun dokumentasi riset, hingga mengeksekusi repurposing konten lintas platform.
Panduan ini mengupas tuntas realitas mengapa cara konvensional kerap gagal, kerangka kerja sistematis pemrosesan audio-ke-teks, alur implementasi praktis langkah demi langkah, serta bagaimana otomatisasi modern mentransformasi efisiensi operasional Anda.
Realitas Lapangan: Mengapa Pendekatan Konvensional Sering Mengecewakan
Banyak profesional masih mengandalkan cara pintas seperti ekstensi browser gratisan atau menyalin transkrip bawaan pemutar video. Di lapangan, pendekatan instan ini hampir selalu berujung pada kekecewaan karena tiga batasan teknis mendasar:
1. Ketergantungan pada ASR Generik Latensi Rendah
YouTube menggunakan sistem Automatic Speech Recognition (ASR) yang dioptimalkan untuk memproses jutaan jam video per hari dengan latensi seringan mungkin. Konsekuensinya adalah penurunan presisi. Sistem ini sering gagal menangkap jargon industri khusus, nama orang, akronim teknis, atau percakapan bilingual (campuran Bahasa Indonesia dan Inggris) yang sangat lumrah dalam podcast bisnis dan teknologi. Selain itu, ketiadaan tanda baca standar dan huruf kapital membuat teks sulit dibaca tanpa penyuntingan menyeluruh.
2. Inkonsistensi Kualitas Audio dan Akustik Ruang
Video di YouTube diproduksi dengan variasi mikrofon yang sangat lebar. Mulai dari rekaman studio kedap suara hingga rekaman lapangan dengan gema ruangan (reverberation) dan kebisingan latar (ambient noise). Generator teks sederhana tidak memiliki lapisan pra-pemrosesan audio untuk menekan frekuensi bising, sehingga memicu lonjakan Word Error Rate (WER) yang mengacaukan konteks pembicaraan.
3. Ketiadaan Pemisahan Identitas Pembicara (Speaker Diarization)
Pada format diskusi panel atau wawancara podcast dua arah, teks mentah tanpa label pembicara menghasilkan tumpukan teks monolitik. Editor editorial tetap harus memutar ulang rekaman berulang kali hanya untuk menandai siapa yang melontarkan argumen tertentu. Mengetik secara manual juga bukan solusi yang layak dipertahankan: rasio rata-rata transkripsi manual manusia berkisar antara 1:4 hingga 1:6, yang berarti video berdurasi 60 menit menuntut 4 hingga 6 jam kerja fokus hanya untuk draf pertama.
Kerangka Kerja A-P-E: Fondasi Strategis Ekstraksi Audio ke Teks
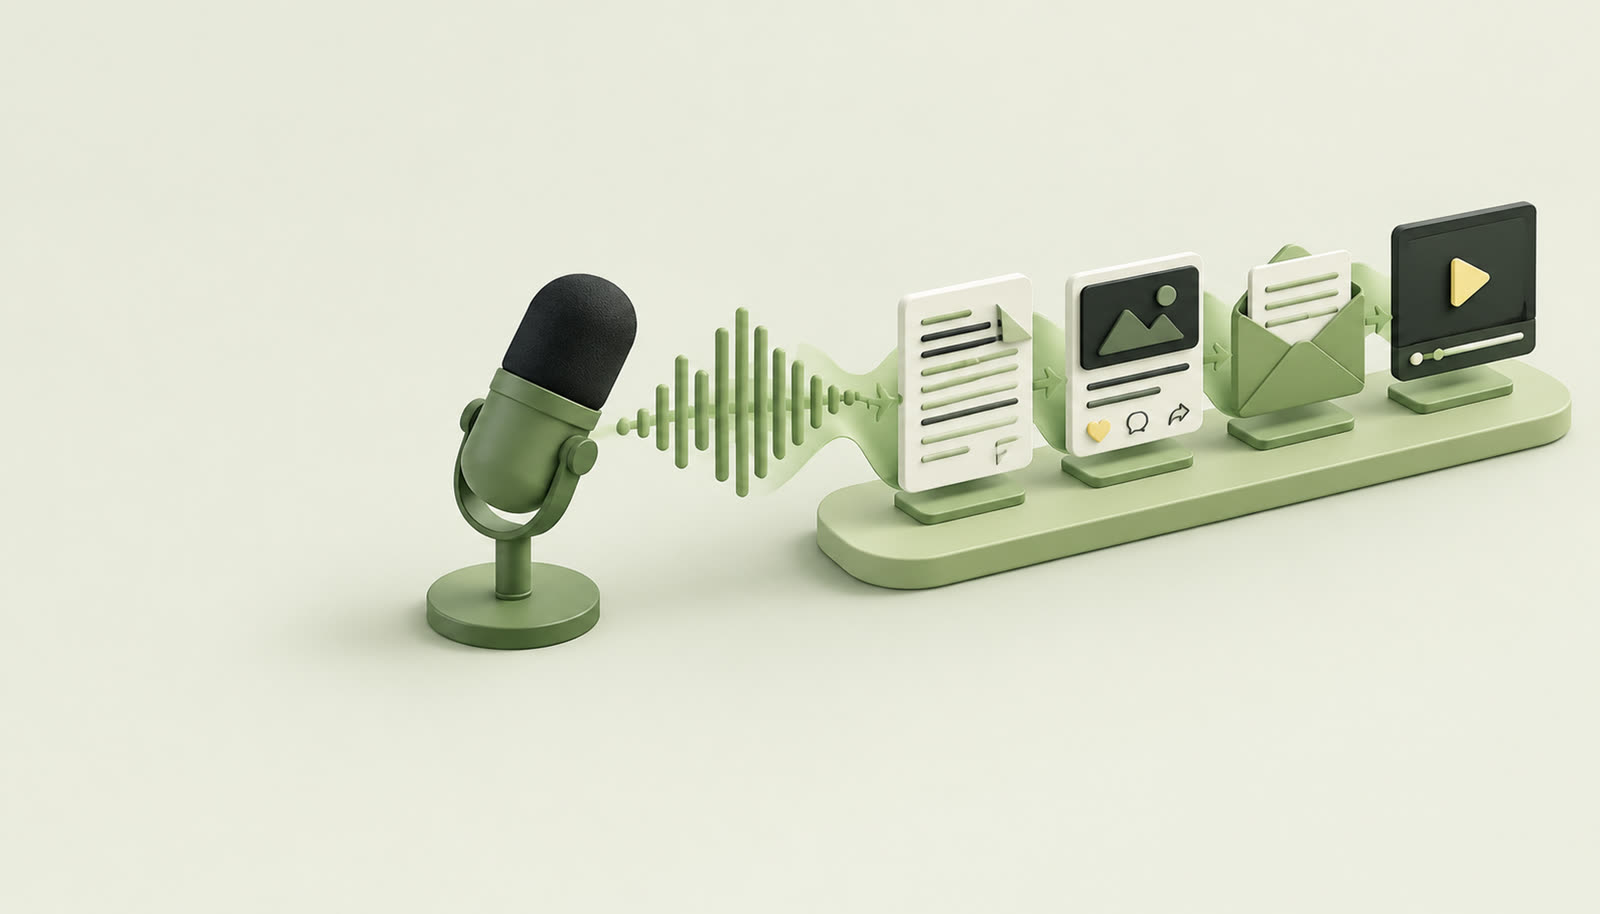
Agar proses transkripsi menghasilkan dokumen yang siap pakai tanpa membuang jam kerja tim, Anda memerlukan metodologi baku. Kami menerapkan kerangka kerja A-P-E (Acquisition, Processing, Enhancement) sebagai standar operasional:
1. Acquisition (Isolasi Audio Berkualitas)
Langkah awal adalah memisahkan trek audio dari kontainer video. Mengirim seluruh file video beresolusi 1080p atau 4K ke mesin transkripsi memboroskan bandwidth dan daya komputasi tanpa memberikan faedah apa pun terhadap ketelitian teks. Anda hanya membutuhkan sinyal audio terkompresi dengan baik.
Standar akuisisi audio yang ideal:
- Format audio mono 16-bit dengan sample rate 16 kHz sudah sangat memadai bagi model speech-to-text modern.
- Format lossy seperti AAC atau MP3 pada bitrate 128 kbps ke atas mempertahankan kejernihan fonem vokal secara optimal.
2. Processing (Inferensi Akustik dan Diarization)
Tahap ini merupakan inti konversi dari gelombang suara menjadi representasi teks tertulis. Di sini, sistem AI mutakhir seperti arsitektur Whisper atau Conformer bekerja menganalisis spektrogram frekuensi audio.
Elemen krusial pemrosesan:
- Pencocokan Konteks Global: Model menganalisis kalimat secara utuh alih-alih menerjemahkan suku kata per suku kata, sehingga tebakan kata menjadi tepat sesuai alur topik.
- Speaker Diarization: Algoritma clustering mengelompokkan karakteristik frekuensi pita suara untuk membedakan Pembicara 1, Pembicara 2, dan seterusnya secara presisi.
3. Enhancement (Kurasi dan Restrukturisasi Tata Bahasa)
Teks mentah hasil mesin masih membawa tabiat bahasa lisan yang berantakan. Tahap akhir ini memoles teks menjadi dokumen profesional yang nyaman dibaca.
Fokus penyempurnaan:
- Pembersihan kata jeda nirfaedah (filler words) seperti "ehm", "anu", "kayak", dan pengulangan gagap.
- Penataan struktur paragraf logis, pemulihan huruf kapital pada nama merek, serta penambahan tanda kutip dialog langsung.
Panduan Langkah Demi Langkah: Implementasi Transkrip Video YouTube ke Teks
Berikut adalah panduan taktis yang dapat Anda jalankan untuk mentranskrip video YouTube apa pun secara mandiri, bahkan saat pembuat video tidak mengaktifkan fitur subtitle sama sekali.
Langkah 1: Ekstraksi File Audio dari Sumber YouTube
Jangan mengunduh file video utuh jika Anda hanya memerlukan transkrip teks.
- Salin tautan URL video YouTube yang ditargetkan.
- Gunakan utilitas ekstraksi audio tepercaya, misalnya utilitas command-line open-source seperti
yt-dlpyang dapat dijalankan di terminal lokal atau server:
```bash
yt-dlp -x --audio-format mp3 --audio-quality 0 "https://www.youtube.com/watch?v=CONTOH_ID"
```
- Verifikasi integritas file audio hasil ekstraksi. Pastikan tidak ada segmen hening panjang di awal yang dapat mengganggu sinkronisasi timestamp transkrip.
Langkah 2: Pemrosesan Menggunakan Model Speech-to-Text Berbasis AI
Setelah audio tersimpan, teruskan file ke mesin transkripsi modern.
- Tentukan lingkungan inferensi: Anda dapat memanfaatkan model Whisper lokal (menggunakan implementasi ringan seperti whisper.cpp atau faster-whisper) atau layanan API cloud speech-to-text bereputasi tinggi.
- Kunci pengaturan bahasa: Sangat disarankan untuk menetapkan parameter bahasa secara eksplisit (misalnya
language: iduntuk Bahasa Indonesia) ketimbang mengandalkan deteksi otomatis. Hal ini mencegah model keliru menafsirkan aksen daerah sebagai bahasa asing. - Pertahankan penanda waktu (timestamps): Pastikan pengaturan ekstraksi menyertakan metadata waktu pada tingkat kalimat. Penanda waktu sangat bernilai saat Anda perlu meninjau kembali cuplikan audio tertentu untuk verifikasi kutipan.
Langkah 3: Kurasi Editorial dan Penataan Format Akhir
Teks yang dihasilkan model AI harus melewati kurasi cepat sebelum didistribusikan.
- Lakukan pencarian cepat (find and replace) untuk kata-kata teknis atau nama tokoh yang rentan salah dengar.
- Bagi teks menjadi paragraf-paragraf tematik berukuran 3 hingga 5 baris agar memudahkan pemindaian mata pembaca.
- Simpan dokumen akhir dalam format fleksibel seperti Markdown (.md) lengkap dengan heading dan informasi narasumber.
Matriks Keputusan: Memilih Metode Transkripsi Sesuai Skala Kebutuhan
Setiap metode memiliki kompromi antara biaya waktu, ketelitian, dan kerumitan teknis. Gunakan matriks evaluasi berikut untuk menentukan solusi yang paling tepat bagi alur kerja tim Anda:
| Metode Transkripsi | Akurasi Rata-rata | Kecepatan Proses | Pemisahan Pembicara | Kompleksitas Teknis | Skalabilitas Produksi |
|---|---|---|---|---|---|
| Pengetikan Manual | 98% - 99% | Sangat Lambat (4-6x durasi) | Penuh (Manual oleh editor) | Sangat Rendah | Sangat Rendah (Menghambat tim) |
| Fitur Bawaan YouTube (CC) | 60% - 75% | Instan (Jika aktif) | Tidak Tersedia | Sangat Rendah | Rendah (Kerap kosong/salah) |
| Model Whisper Open-Source Lokal | 90% - 95% | Cepat (Tergantung GPU) | Perlu modul tambahan (PyAnnote) | Tinggi (Setup CLI / Python) | Sedang (Dibatasi perangkat keras) |
| Platform Otomatisasi Terintegrasi | 95% - 98% | Sangat Cepat (Cloud server) | Otomatis dan Terkalibrasi | Sangat Rendah (Cukup tempel URL) | Sangat Tinggi (Batch processing siap pakai) |
Bagi kreator yang memproduksi satu video pendek dalam sebulan, menjalankan skrip lokal mungkin sudah cukup. Namun bagi agensi konten, podcaster profesional, dan divisi media perusahaan yang memproses puluhan jam rekaman mingguan, otomasi menyeluruh berbasis cloud adalah pilihan logis untuk menjaga profitabilitas waktu.
Otomasi Alur Kerja Transkripsi dan Repurposing dengan Podlyzer
Menghasilkan file teks berformat dokumen hanyalah separuh jalan. Titik balik nilai komersial dari sebuah video atau rekaman audio podcast baru dirasakan saat transkrip tersebut diolah menjadi aset konten siap sebar yang mendatangkan audiens dan otoritas merek. Mengelola seluruh proses ini secara terpisah lewat berbagai aplikasi pihak ketiga kerap memunculkan hambatan birokrasi baru.
Platform seperti Podlyzer diciptakan untuk menutup celah inefisiensi tersebut secara elegan:
- Ingesti Langsung dari Tautan: Anda tidak perlu membuang bandwidth untuk mengunduh video dan mengekstrak audio secara manual. Cukup masukkan URL video YouTube ke dalam platform, dan sistem akan memproses stream suara secara instan di cloud.
- Transkripsi Cerdas dengan Diarization: Didukung model speech-to-text terlatih untuk konteks percakapan lokal, Podlyzer secara otomatis mengenali pergantian antar-narasumber, menyematkan tanda baca yang rapi, dan memisahkan alur dialog dengan tingkat akurasi tinggi.
- Transformasi Menjadi 15 Format Konten: Daripada membiarkan teks mentah mengendap di dalam folder komputer, mesin generator Podlyzer langsung mengekstrak inti pembicaraan menjadi artikel blog SEO-ready, buletin email newsletter, draf postingan LinkedIn dengan hook memikat, thread informatif di X, hingga naskah slide carousel edukatif dan show notes terstruktur.
Dengan menyerahkan pekerjaan teknis ekstraksi dan repurposing kepada sistem terintegrasi, tim konten dapat mengalihkan energi mereka sepenuhnya ke strategi distribusi dan pengembangan ide kreatif.
Kesimpulan dan Rangkuman Tindakan Nyata
Ketiadaan subtitle pada video YouTube yang sarat wawasan tidak boleh lagi menjadi penghalang produktivitas Anda. Mengandalkan metode manual atau alat bantu seadanya terbukti membuang waktu dan menghasilkan dokumen berkualitas rendah.
Untuk memulai perbaikan alur kerja konten Anda hari ini, terapkan daftar tindakan nyata berikut:
- Tinggalkan Pengetikan Manual: Hitung nilai per jam kerja tim Anda. Mengalihkan proses awal transkripsi ke model kecerdasan buatan langsung memangkas setidaknya 80 persen waktu kerja rutin.
- Terapkan Kerangka Kerja A-P-E: Pastikan alur kerja Anda selalu memisahkan isolasi audio bersih, pemrosesan inferensi dengan kemampuan diarization pembicara, dan kurasi teks terstruktur.
- Jangan Berhenti di Dokumen Mentah: Jadikan setiap transkrip video YouTube sebagai repositori wawasan untuk diproduksi ulang menjadi berbagai format konten distribusi yang memperluas jangkauan audiens Anda di berbagai kanal media sosial.
Pertanyaan yang sering diajukan
Apakah legal mentranskrip video YouTube milik pihak lain menjadi format teks?
Mentranskrip video publik untuk keperluan riset pribadi, studi kasus internal, analisis data, atau ulasan wajar (fair use) umumnya diperbolehkan. Namun, mempublikasikan ulang naskah transkrip secara utuh kata demi kata ke publik tanpa izin atau tanpa mencantumkan atribusi pemilik hak cipta dapat melanggar hak cipta dan ketentuan platform. Praktik terbaik adalah menjadikan transkrip sebagai bahan rujukan untuk menyusun sintesis konten baru yang orisinal.
Bagaimana cara menangani video dengan narasumber yang sering berbicara saling tumpang tindih?
Kondisi suara yang saling bertumpuk (cross-talk) merupakan tantangan teknis tersulit bagi model speech-to-text. Untuk meminimalkan kesalahan, gunakan mesin transkripsi yang memiliki fitur speaker diarization berbasis voice embedding mutakhir. Jika memungkinkan, terapkan filter isolasi vokal sebelum transkripsi, serta lakukan pengecekan manual terfokus khusus pada penanda waktu di mana perdebatan atau interupsi suara terjadi.
Mengapa model transkripsi AI terkadang memunculkan kata halusinasi yang tidak diucapkan pembicara?
Halusinasi kata pada model ASR biasanya dipicu oleh durasi hening (silence) yang terlalu panjang, volume musik latar belakang yang menenggelamkan vokal, atau kualitas noise lantai yang buruk. Model AI berusaha keras mencocokkan pola frekuensi acak tersebut dengan perbendaharaan kata yang dipelajarinya. Menjalankan fungsi silence removal dan normalisasi volume vokal sebelum proses transkripsi terbukti efektif menghilangkan potensi halusinasi teks.