AI untuk Kreator Podcast: Optimasi Alur Kerja Produksi Audio Modern
Audio & AI · 2026-09-23 · 7 menit baca · Tim Editorial Podlyzer
Memproduksi episode podcast berkualitas kini bukan lagi soal menghabiskan puluhan jam di meja editing. Temukan bagaimana implementasi AI mentransformasi alur kerja kreator audio secara menyeluruh dan terukur.
Bottleneck Produksi Audio: Mengapa Alur Kerja Konvensional Menghambat Pertumbuhan
Sebagian besar kreator podcast dan produser audio memulai proyek mereka dengan antusiasme naratif yang tinggi, namun sering kali terbentur pada realitas operasional yang melelahkan. Untuk setiap satu jam rekaman audio mentah, seorang kreator konvensional rata-rata menghabiskan waktu antara empat hingga delapan jam hanya untuk tugas-tugas non-kreatif. Siklus ini mencakup pemotongan noise latar belakang, penghapusan kata jeda (filler words), mendengarkan ulang berulang kali untuk mencatat cap waktu (timestamps), hingga transkripsi manual yang memakan tenaga.
Kondisi ini menciptakan hambatan operasional yang nyata:
- Kelelahan Produksi (Production Fatigue): Energi mental produser terkuras habis pada tahap pasca-produksi teknis, menyisakan sedikit ruang untuk riset naskah atau pengembangan konsep episode berikutnya.
- Keterlambatan Siklus Rilis: Jadwal penayangan sering kali molor karena proses editing linier yang kaku dan lambat.
- Distribusi yang Terisolasi: Audio berkualitas tinggi berakhir hanya tersimpan di direktori podcast tanpa amplifikasi ke kanal media sosial, karena tim tidak memiliki bandwidth untuk menulis posting LinkedIn, thread X, atau ringkasan newsletter.
Pendekatan konvensional memposisikan file audio sebagai produk akhir tunggal yang terisolasi. Padahal, dalam lanskap konsumsi konten modern, satu percakapan berdurasi 60 menit adalah tambang emas informasi yang menyimpan puluhan ide, kutipan bernas, dan wawasan industri. Mengabaikan potensi repurposing ini sama saja dengan membuang 80 persen nilai potensial dari setiap sesi rekaman.
Kerangka Kerja Strategis: The Modern Audio Pipeline Framework
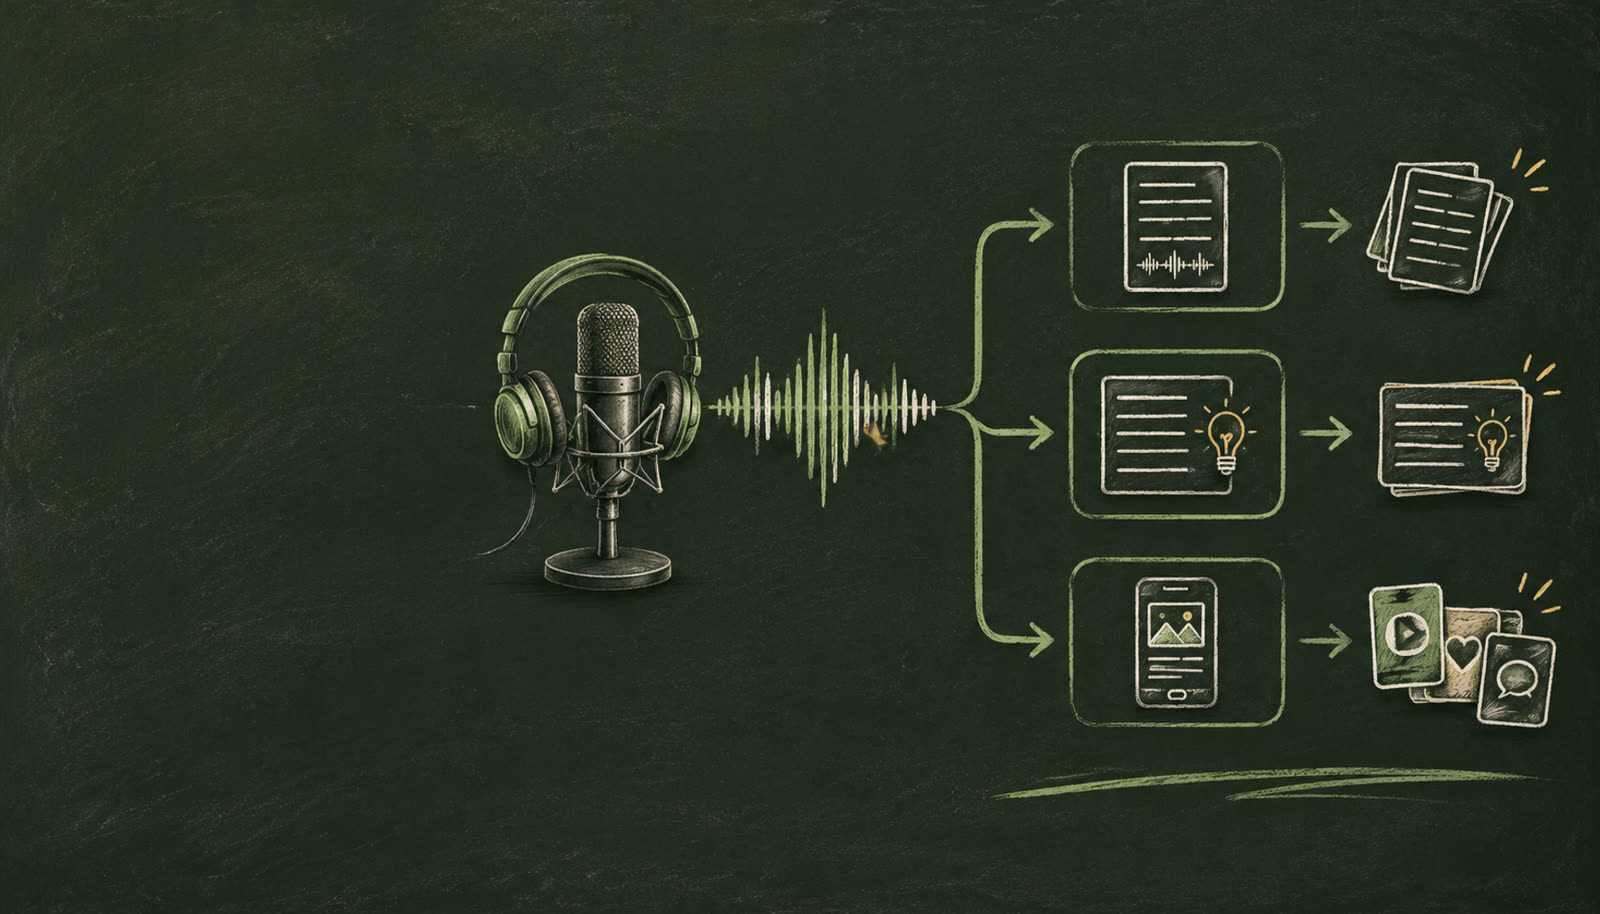
Untuk keluar dari jebakan inefisiensi tersebut, kreator audio profesional perlu mengadopsi pendekatan sistemik. Bukan sekadar memakai tools acak, melainkan membangun alur terintegrasi melalui The Modern Audio Pipeline Framework. Kerangka kerja ini membagi siklus produksi audio menjadi tiga pilar utama:
1. Ingestion & Intelligent Pre-Processing
Pilar pertama berfokus pada standardisasi masukan audio dan pembersihan otomatis. Di tahap ini, algoritma machine learning bekerja menyaring gangguan frekuensi, menyeimbangkan dinamika volume antar-pembicara (loudness normalization), dan mendeteksi segmen audio yang rusak tanpa perlu manipulasi manual parameter kompresor atau equalizer yang rumit.
2. Semantic Extraction & Deep Understanding
Pilar kedua adalah jembatan antara audio mentah dan teks terstruktur. Melalui model pengenalan suara modern (automatic speech recognition) yang dipadukan dengan speaker diarization, sistem tidak hanya mengubah gelombang suara menjadi kata-kata, tetapi juga memahami konteks: siapa yang berbicara, kapan topik berganti, serta bagian mana yang mengandung argumen kunci atau anekdot paling menarik.
3. Multi-Format Content Cascading
Pilar ketiga adalah fase penggandaan nilai. Dari transkrip semantik yang telah diindeks, mesin pemrosesan bahasa alami (NLP) membedah struktur percakapan untuk menghasilkan turunan konten dalam berbagai format hierarkis: artikel panduan mendalam untuk blog, show notes berstruktur rapi untuk deskripsi platform podcast, draf newsletter mingguan, hingga rangkuman ringkas untuk media sosial profesional.
Panduan Implementasi Langkah demi Langkah: Dari Rekaman Kasar ke Multi-Kanal
Mengubah alur kerja manual menjadi sistem berbasis kecerdasan buatan membutuhkan disiplin eksekusi yang runtut. Berikut adalah tiga langkah taktis yang dapat langsung diterapkan dalam proses produksi Anda:
Langkah 1: Otomasi Transkripsi dan Penandaan Pembicara (Speaker Diarization)
Segera setelah rekaman selesai, unggah file master audio tanpa melalui proses editing potong-sambung terlebih dahulu. Manfaatkan teknologi transkripsi otomatis yang mendukung pemisahan identitas pembicara. Fitur speaker diarization sangat krusial di sini karena membedakan secara tegas antara pewawancara dan narasumber. Dengan demikian, Anda memiliki teks sumber yang akurat lengkap dengan penanda waktu, memungkinkan Anda meninjau isi percakapan secara visual hanya dalam hitungan menit tanpa harus memutar ulang rekaman berkecepatan normal.
Langkah 2: Pembersihan Audio Semantik dan Ekstraksi Momen Kunci
Alih-alih mencari kata jeda seperti 'umm', 'ahh', atau repetisi kata secara manual di timeline Digital Audio Workstation (DAW), gunakan editor berbasis teks. Dengan metode ini, menghapus kalimat atau jeda canggung pada transkrip teks akan secara otomatis memotong segmen audio yang bersangkutan pada file suara. Setelah audio bersih, gunakan analisis semantik untuk menandai tiga hingga lima segmen paling bernilai tinggi yang layak dijadikan cuplikan teaser atau kutipan utama.
Langkah 3: Distribusi Konten Turunan Secara Sistematis
Langkah terakhir adalah mentransformasi transkrip yang telah disunting menjadi berbagai aset pemasaran digital. Jangan biarkan transkrip hanya menjadi teks mentah tak terbaca. Ekstrak poin-poin penting menjadi show notes yang dilengkapi ringkasan eksekutif, cap waktu tematik, serta daftar tautan referensi yang dibahas dalam episode. Selanjutnya, kembangkan argumen inti episode menjadi artikel blog panjang berorientasi SEO serta rangkaian unggahan mikro untuk platform distribusi pilihan audiens Anda.
Matriks Keputusan: Perbandingan Alur Kerja Konvensional vs. Berbasis AI
Tabel berikut memetakan perbedaan efisiensi operasional antara kedua pendekatan pada produksi satu episode podcast berdurasi 60 menit:
| Parameter Evaluasi | Alur Kerja Konvensional | Alur Kerja Berbasis AI | Dampak Operasional |
|---|---|---|---|
| Waktu Transkripsi | 3-5 Jam (Manual / Outsourcing) | 2-5 Menit (Transkripsi Otomatis) | Penghematan waktu hingga 95% |
| Identifikasi Pembicara | Penandaan manual per kalimat | Speaker Diarization otomatis | Navigasi dialog instan & presisi |
| Editing Kata Jeda (Fillers) | Pemotongan manual di timeline audio | Deteksi & eliminasi teks satu klik | Menghilangkan kelelahan visual editing |
| Penyusunan Show Notes | Menulis ulang sambil memutar audio | Generator rangkuman berbasis konteks | Format baku dan terbit lebih cepat |
| Repurposing Konten | Terbatas (1-2 posting sosial media) | 10-15 format aset turunan instan | Jangkauan audiens berlipat ganda |
| Estimasi Total Waktu Pasca-Produksi | 8-12 Jam per episode | 1.5-2.5 Jam per episode | Kapasitas produksi naik 4-5 kali lipat |
Mengintegrasikan Otomasi Cerdas Melalui Platform Modern
Penerapan alur kerja berbasis AI secara terpisah menggunakan belasan aplikasi berbeda sering kali memunculkan masalah baru: fragmentasi data dan inefisiensi biaya operasional. Di sinilah ekosistem terpadu seperti Podlyzer mengambil peran krusial dalam menyederhanakan siklus pasca-produksi.
Melalui teknologi pemrosesan audio canggih, platform seperti Podlyzer memadukan mesin transkrip otomatis berpresisi tinggi dengan kemampuan speaker diarization cerdas yang mampu mengenali dinamika pergantian pembicara dalam diskusi multipihak. Kreator tidak perlu lagi mengekspor transkrip ke dokumen terpisah hanya untuk menyusun materi promosi.
Fitur generator turunan konten pada platform ini secara otomatis mengonversi rekaman mentah menjadi show notes terstruktur, draf newsletter berkategori, posting otoritatif untuk LinkedIn, thread mendalam untuk X, hingga kerangka carousel edukatif. Pendekatan terintegrasi ini memungkinkan produser berfokus penuh pada kurasi ide dan interaksi komunitas, sementara beban repetitif pasca-produksi diselesaikan oleh sistem secara otomatis dan konsisten.
Kesimpulan dan Rangkuman Aksi untuk Kreator Podcast
Pemanfaatan kecerdasan buatan dalam alur kerja kreator podcast bukan tentang menggantikan esensi kreativitas manusia atau keaslian suara narator. Sebaliknya, AI berfungsi sebagai pengungkit operasional (operational leverage) yang membebaskan kreator dari rutinitas teknis yang melelahkan. Dengan mengotomasi proses transkripsi, pembersihan audio, dan diversifikasi format, kreator dapat memperluas dampak pesan mereka ke berbagai segmen audiens secara simultan.
Daftar Aksi Prioritas Minggu Ini
- Audit Alur Kerja Saat Ini: Catat secara rinci berapa jam yang dihabiskan tim Anda untuk transkripsi, editing audio, dan penulisan konten promosi pada episode terakhir.
- Standardisasi Format Sumber: Pastikan kualitas input rekaman memiliki rasio signal-to-noise yang baik agar model AI dapat mengenali percakapan dan pembicara dengan akurasi optimal.
- Uji Coba Repurposing Sistematis: Mulai dari satu episode rekaman, gunakan sistem otomatis untuk menghasilkan show notes lengkap, satu artikel blog teknis, dan tiga draf posting sosial media.
- Bandingkan ROI Operasional: Evaluasi penurunan jam kerja pasca-produksi dan peningkatan impresi konten di kanal-kanal distribusi sekunder.
Pertanyaan yang sering diajukan
Apakah penggunaan AI untuk kreator podcast akan mengurangi sentuhan personal atau keaslian suara kreator?
Tidak, jika digunakan secara tepat. AI bertindak sebagai asisten operasional yang menangani pekerjaan repetitif seperti transkripsi, penataan cap waktu, dan perumusan draf awal konten turunan. Keputusan kurasi pesan, gaya bahasa akhir, dan hubungan emosional dengan pendengar tetap berada sepenuhnya di bawah kendali kreator.
Seberapa akurat teknologi transkripsi otomatis dan speaker diarization dalam membedakan percakapan bahasa Indonesia?
Model pengenalan suara modern saat ini memiliki tingkat akurasi di atas 90 persen untuk rekaman audio dengan kualitas vokal yang jelas. Fitur speaker diarization mampu membedakan frekuensi suara tiap pembicara secara presisi, sehingga dialog antar-narasumber langsung terpisah rapi tanpa perlu koreksi manual yang intensif.
Mengapa kreator audio perlu mengubah rekaman podcast menjadi format teks seperti artikel blog dan newsletter?
Mesin pencari mengindeks teks secara jauh lebih efektif dibandingkan file audio mentah. Dengan mengubah episode podcast menjadi artikel blog berbasis SEO dan newsletter, Anda membuka peluang mendapatkan traffic organik berkelanjutan serta menjangkau audiens profesional yang lebih gemar membaca ringkasan teks daripada mendengarkan audio berdurasi penuh.