Mengenali Suara Pembicara di Banyak Episode Podcast Lewat Voice Profile
Audio & AI · 2026-10-12 · 8 menit baca · Tim Editorial Podlyzer
Mengelola identitas pembicara di ratusan episode podcast sering kali memicu kekacauan metadata. Pelajari bagaimana teknologi voice profile dan audio embedding memecahkan masalah ini secara presisi.
Akar Masalah Mengapa Diarization Tradisional Gagal di Skala Episode
Bagi tim produksi yang mengelola katalog podcast puluhan hingga ratusan episode, pengenalan pembicara adalah sumber hambatan terbesar dalam pascaproduksi. Banyak produser mengandalkan alat transkripsi berbasis kecerdasan buatan standar dengan modul speaker diarization bawaan. Namun, ada kelemahan mendasar: model diarization konvensional beroperasi secara terisolasi per file audio (single-session clustering).
Ketika Anda memproses Episode 42, sistem mengelompokkan segmen ke klaster acak seperti "Speaker 1" dan "Speaker 2". Saat Episode 43 diproses keesokan harinya dengan pembawa acara dan narasumber yang sama, model mengulang proses dari nol. Suara host utama yang sebelumnya dilabeli "Speaker 1" kini terdeteksi sebagai "Speaker 2", sementara narasumber tamu berubah menjadi "Speaker 1".
Akibat inkonsistensi ini, tim editorial menghabiskan 20 hingga 30 menit per episode hanya untuk mencocokkan identitas pembicara secara manual. Dalam skala jejaring media yang merilis beberapa episode per minggu, inefisiensi ini membuang belasan jam kerja produktif setiap bulan.
Kondisi ini diperparah oleh variasi lingkungan akustik:
- Perbedaan Perangkat Rekaman: Pembicara menggunakan mikrofon studio XLR di episode tertentu, lalu beralih ke headset kabel via panggilan video daring di episode lain.
- Dinamika Vokal Spontan: Tawa lepas, intonasi tinggi saat berdebat, atau vokal serak saat host kurang fit sering memicu algoritma menciptakan klaster pembicara baru padahal orangnya sama.
- Tumpang Tindih Suara (Overlapping Speech): Saat dua orang berbicara bersamaan, model dasar kerap mengalami kegagalan segmentasi dan memotong kalimat krusial.
Ketika transkrip dasar mengalami salah atribusi, seluruh materi turunan seperti kutipan media sosial, newsletter, hingga artikel blog SEO akan mengutip nama yang keliru. Menghapus kekacauan ini memerlukan transisi dari sekadar diarization per episode menuju sistem identifikasi berbasis persistent voice profile.
Kerangka Kerja Strategis: Arsitektur Voice Profile Berbasis Deep Speaker Embeddings
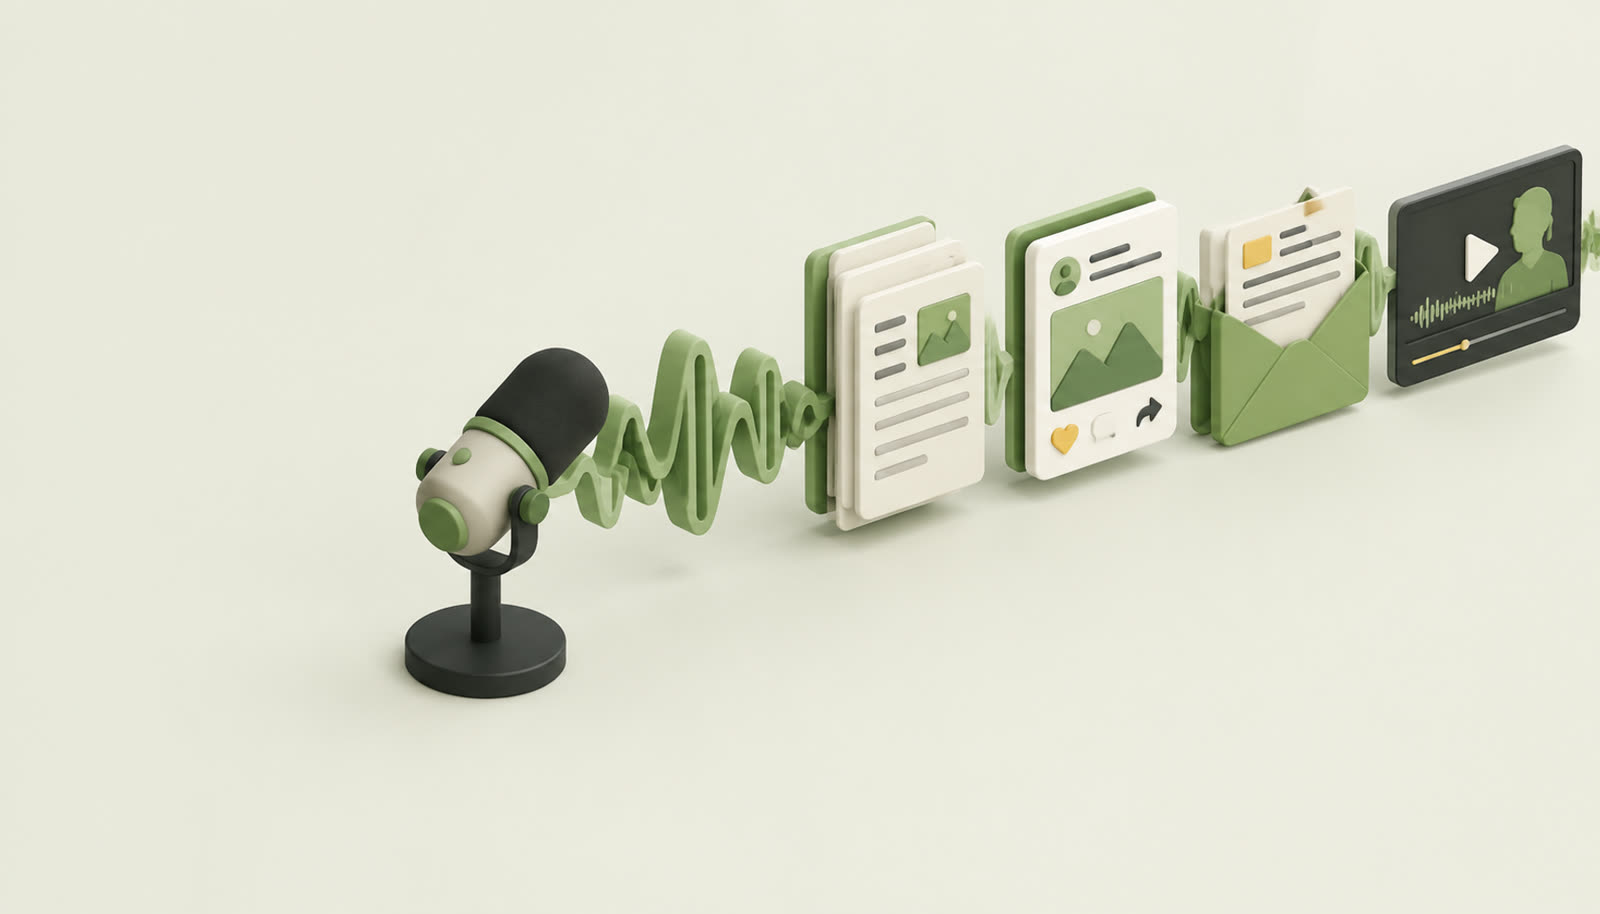
Mengatasi tantangan lintas episode menuntut arsitektur yang mampu mengenali biometrik vokal terlepas dari topik obrolan, durasi rekaman, atau variasi mikrofon. Kerangka kerja ini bertumpu pada deep speaker embeddings dan basis data profil vokal terdistribusi.
Alur pengenalan suara pembicara podcast modern melibatkan empat pilar arsitektur:
- Ekstraksi Fitur Akustik Dasar: Sinyal audio mentah dinormalisasi dan dipecah menjadi bingkai pendek (short-time frames) berdurasi 20-30 milidetik. Dari bingkai ini diekstraksi representasi spektral seperti Log-Mel Filterbank Energies atau MFCCs yang menangkap karakteristik resonansi saluran vokal unik tiap individu.
- Deep Speaker Embeddings (ECAPA-TDNN): Fitur spektral diproses melalui jaringan saraf tiruan seperti arsitektur ECAPA-TDNN (Emphasized Channel Attention, Propagation and Aggregation Time Delay Neural Network). Jaringan ini memproyeksikan karakteristik suara menjadi vektor angka berdimensi tetap (fixed-length dense vector), umumnya berukuran 192 hingga 512 dimensi. Vektor ini berfungsi sebagai sidik suara matematis (voice embedding).
- Speaker Registry Terpusat: Berbeda dari transkripsi sekali pakai yang membuang data vokal seusai proses, sistem voice profile menyimpan vektor referensi pembicara ke dalam basis data vektor. Setiap profil (misalnya: "Sarah - Host", "Budi - Co-Host") menyimpan titik tengah representasi (centroid embedding) dari sampel suara yang telah diverifikasi.
- Pencocokan Jarak Kosinus (Cosine Similarity): Saat episode baru diproses, vektor segmen suara baru dibandingkan dengan vektor referensi di registry menggunakan kalkulasi cosine similarity. Jika skor kemiripan melampaui ambang batas (misalnya minimal 0.78), label nama pembicara langsung disematkan otomatis tanpa intervensi editor.
Panduan Langkah demi Langkah Implementasi Voice Profile Lintas Episode
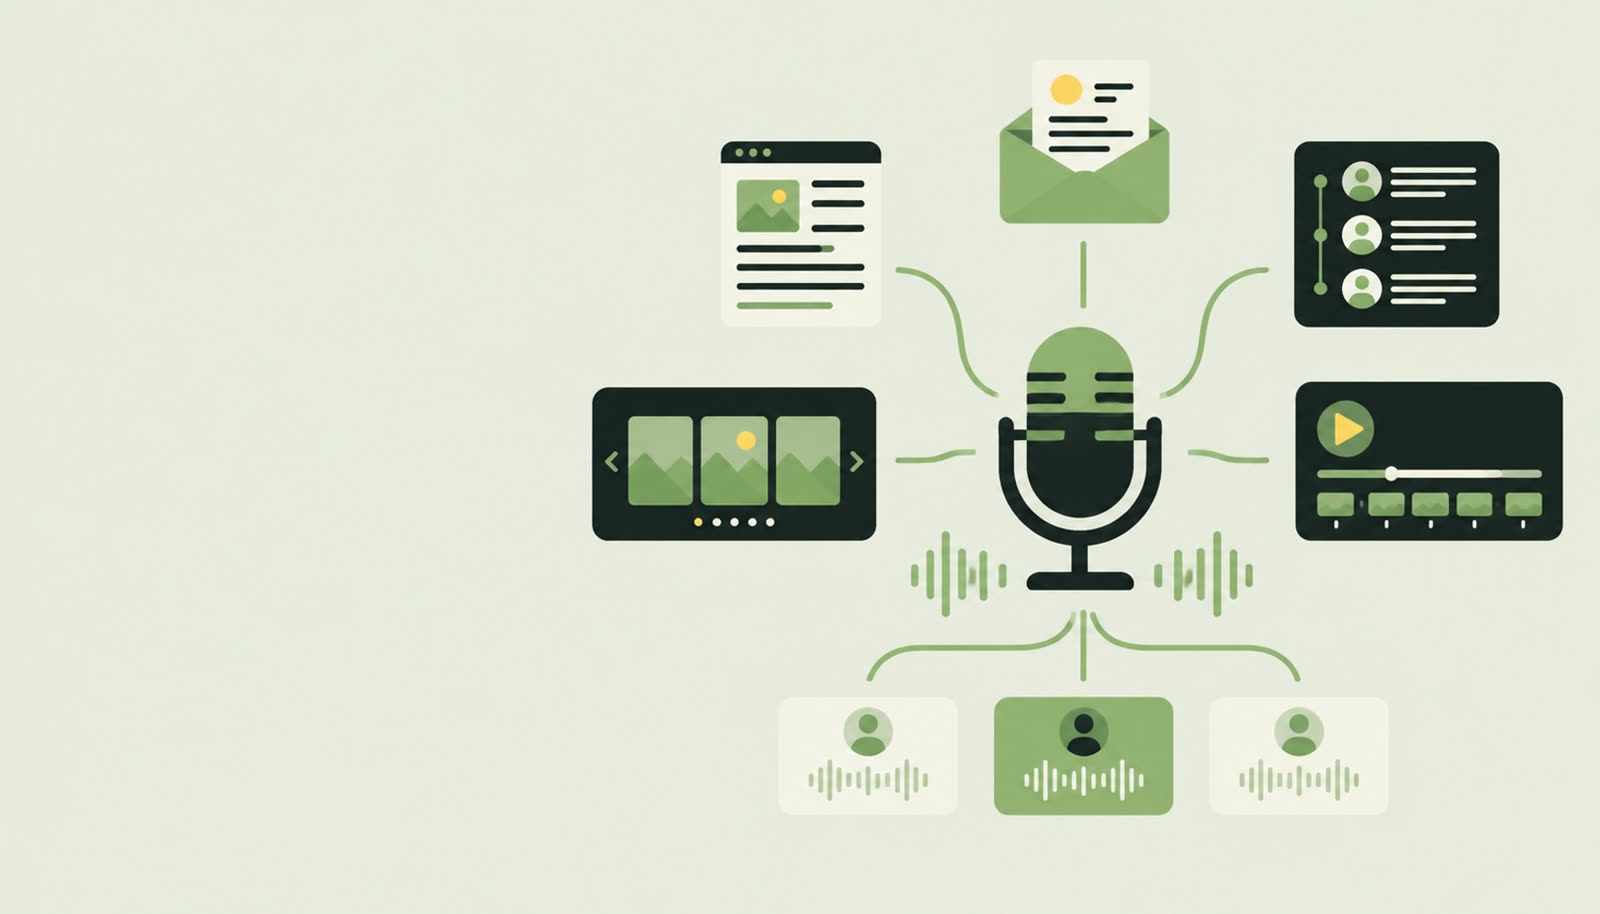
Menerapkan sistem pengenalan suara pembicara podcast ke alur kerja harian dapat dilakukan melalui tahapan taktis berikut:
Langkah 1: Kurasi Sampel Enrolment Berkualitas Tinggi
Keberhasilan pengenalan vokal bergantung pada kebersihan data pendaftaran (enrolment data):
- Gunakan Audio Bersih: Ambil sampel suara pembicara berdurasi 45-90 detik dengan tempo wajar, volume stabil, dan tanpa musik latar (background music).
- Cegah Kebocoran Suara: Pastikan tidak ada suara tawa rekan bicara, kebisingan ruangan, atau gema (reverb) yang masuk ke trek audio.
- Hindari Efek Berlebih: Gunakan rekaman vokal mentah yang bebas dari pemrosesan ekstrem seperti heavy auto-tune atau distorsi agresif agar bentuk formasi frekuensi vokal tetap presisi.
Langkah 2: Kalibrasi Ambang Batas Kemiripan (Similarity Threshold)
Pengaturan sensitivitas pencocokan vektor krusial untuk mencegah false positive (salah mendeteksi tamu sebagai host) dan false negative (gagal mengenali host):
- Ambang Batas Ketat (skor 0.82 ke atas): Tepat untuk rekaman monolog atau dialog formal dengan mikrofon kondensor berkualitas tinggi.
- Ambang Batas Seimbang (skor 0.76 - 0.81): Standar ideal untuk podcast kasual, rekaman jarak jauh via aplikasi konferensi, dan diskusi multi-pembicara. Rentang ini memberikan toleransi akustik tanpa mencampuradukkan karakter vokal yang mirip.
- Ambang Batas Longgar (di bawah 0.75): Berisiko memicu salah atribusi, khususnya antara dua pembicara dengan register vokal yang berdekatan.
Langkah 3: Eksekusi Pipeline Diarization Terintegrasi
Setelah profil terdaftar, jalankan pipeline pemrosesan rekaman:
- Lakukan Voice Activity Detection (VAD) untuk memotong bagian jeda hening (silence).
- Segmentasikan audio berdasarkan titik pergantian pembicara (speaker turning points).
- Cocokkan vektor tiap segmen terhadap Speaker Registry yang tersimpan.
- Terapkan unsupervised clustering hanya pada sisa segmen yang tidak terpetakan untuk mengelompokkan narasumber baru.
- Lakukan peninjauan visual kilat (spot-check) pada segmen dengan skor marjinal (0.74 - 0.76) sebelum materi transkrip diteruskan ke tim editorial.
Langkah 4: Pembaruan Profil Dinamis (Rolling Centroid)
Vokal pembicara dapat mengalami sedikit perubahan karena pergantian mikrofon atau kondisi fisik. Terapkan strategi rolling centroid: ketika sebuah segmen teridentifikasi dengan tingkat keyakinan sangat tinggi (di atas 0.90), mutakhirkan vektor referensi pembicara menggunakan rata-rata bergerak berbobot. Hal ini menjaga akurasi profil vokal tetap prima seiring waktu.
Matriks Evaluasi: Diarization Konvensional vs. Voice Profile Lintas Episode
Tabel berikut merangkum perbandingan teknis dan operasional antara pendekatan konvensional per episode dengan sistem berbasis voice profile:
| Parameter Evaluasi | Diarization Konvensional (Per Episode) | Sistem Voice Profile Lintas Episode |
|---|---|---|
| Ruang Lingkup Analisis | Terisolasi pada satu file audio aktif | Terhubung ke basis data vektor vokal historis |
| Konsistensi Label | Acak dan berubah tiap file (Speaker 1, Speaker 2) | Konsisten permanen sesuai nama pembicara asli |
| Beban Kerja Manual | 20 - 30 menit per episode untuk pelabelan | Di bawah 2 menit (hanya verifikasi tamu baru) |
| Penanganan Tamu Rutin | Harus dilabeli manual setiap kali hadir kembali | Terdeteksi otomatis begitu profil pernah disimpan |
| Toleransi Perubahan Mikrofon | Rentan salah mengira sebagai orang berbeda | Tetap akurat mengenali biometrik suara berkat embedding |
| Kesiapan Repurposing | Memerlukan penyuntingan sebelum konten dibuat | Transkrip langsung siap diubah menjadi aneka aset |
| Skalabilitas Produksi | Waktu kerja membengkak seiring bertambahnya episode | Waktu kerja pascaproduksi tetap ringkas dan efisien |
Menghubungkan Identifikasi Suara Presisi dengan Otomasi Repurposing di Podlyzer
Mengidentifikasi pembicara secara tepat bukan hanya soal merapikan berkas transkripsi. Dalam strategi konten modern, transkrip podcast adalah single source of truth untuk memproduksi materi multi-kanal. Dari percakapan audio 60 menit, tim pemasaran memproduksi artikel blog, newsletter, utas ringkas di platform X, postingan carousel LinkedIn, hingga show notes.
Di sinilah platform seperti Podlyzer menjadi pembeda utama dalam alur kerja pascaproduksi Anda. Podlyzer memadukan mesin transkripsi otomatis dengan kapabilitas speaker diarization lintas episode yang terhubung ke direktori profil vokal cerdas:
- Pengenalan Otomatis & Konsisten: Podlyzer memetakan pembicara rekaman baru ke dalam profil vokal yang tersimpan di ruang kerja Anda, meniadakan kerepotan mengganti nama pembicara berulang kali.
- Atribusi Kutipan yang Sempurna: Saat menyaring intisari pembahasan, generator Podlyzer mengenali secara persis siapa yang menyampaikan argumen atau studi kasus tertentu. Hal ini mencegah salah kutip pada artikel kepemimpinan opini (thought leadership) atau siaran pers.
- Penerbitan 15 Format Aset Turunan: Dengan metadata pembicara yang tervalidasi sejak awal, Podlyzer secara instan mengubah episode menjadi 15 format aset turunan siap publikasi. Anda memperoleh artikel blog berstruktur kuat, segmen tanya-jawab newsletter, infografis teks untuk media sosial, hingga ringkasan eksekutif dengan cap waktu (timestamps) akurat.
Melalui integrasi langsung antara pengenalan biometrik suara dan pembuatan konten cerdas, tim media dapat menuntaskan proses pascaproduksi dalam hitungan menit.
Kesimpulan dan Rangkuman Aksi untuk Tim Produksi
Ketidakteraturan label pembicara pada rekaman podcast bukan lagi kendala yang harus diterima sebagai beban kerja rutin. Melalui implementasi teknologi voice profile dan vektor embedding suara, Anda dapat membangun alur pascaproduksi yang konsisten, akurat, dan terukur.
Langkah konkret yang dapat Anda jalankan mulai sekarang:
- Inventarisasi Pembicara Utama: Tentukan daftar pembawa acara reguler dan narasumber berulang yang paling sering tampil di program Anda.
- Siapkan Bank Sampel Suara: Ekstrak cuplikan audio bersih 60 detik tanpa musik pengiring untuk masing-masing figur kunci.
- Tetapkan Ambang Batas Ideal: Gunakan nilai kemiripan kosinus 0.77 - 0.80 sebagai titik awal pengenalan vokal yang seimbang.
- Hubungkan ke Sistem Repurposing Terpadu: Manfaatkan platform seperti Podlyzer untuk mengintegrasikan transkrip terverifikasi langsung ke mesin pembuat 15 aset konten turunan.
Dengan menerapkan langkah-langkah di atas, tim produksi dapat menghemat waktu puluhan jam kerja setiap bulan sekaligus menjamin kualitas dan akurasi konten yang didistribusikan ke audiens.
Pertanyaan yang sering diajukan
Berapa durasi sampel audio minimal yang dibutuhkan untuk membuat Voice Profile yang akurat?
Durasi optimal berkisar antara 45 hingga 90 detik audio bersih tanpa musik pengiring atau kebisingan latar. Durasi ini memberikan jendela waktu yang memadai bagi model jaringan saraf tiruan seperti ECAPA-TDNN untuk menangkap pola resonansi dan karakteristik fonetik saluran vokal secara stabil.
Bagaimana sistem mengenali pembicara saat terjadi tumpang tindih suara (cross-talk)?
Sistem modern memanfaatkan modul overlap-aware diarization yang memisahkan komponen frekuensi vokal dominan. Jika segmen suara terlalu bercampur sehingga menghasilkan skor keyakinan rendah, sistem akan menandai bagian tersebut secara otomatis untuk peninjauan visual cepat tanpa mengacaukan segmen percakapan lainnya.
Apakah Voice Profile tetap berfungsi jika narasumber berganti jenis mikrofon?
Ya, model deep speaker embeddings dilatih dengan teknik augmentasi data seperti simulasi variasi akustik dan kompresi audio digital. Pendekatan ini memungkinkan sistem memisahkan karakteristik biologis pita suara dari respons frekuensi mikrofon, sehingga identitas pembicara tetap terdeteksi akurat baik melalui mikrofon studio maupun panggilan daring.