Transkrip Audio ke Teks Bahasa Indonesia: Bedah Masalah dan Solusinya
Audio & AI · 2026-08-28 · 9 menit baca · Tim Editorial Podlyzer
Mengapa hasil transkrip audio ke teks bahasa Indonesia sering kacau dan melenceng? Pelajari akar masalah fonetik, framework kurasi audio, serta teknik otomasi pascaproduksi berbasis AI.
Rekaman wawancara podcast berdurasi satu jam baru saja selesai. Anda mengekspor file audio, mengunggahnya ke platform speech-to-text otomatis, dan menanti naskah matang tersaji dalam hitungan menit. Namun, ketika dokumen dibuka, yang tampak justru barisan teks yang kacau: kalimat terpotong di tengah jalan, istilah bisnis bercampur bahasa Inggris diterjemahkan serampangan menjadi kosakata aneh, dan ucapan kedua pembicara melebur tanpa jeda yang jelas. Alih-alih menghemat waktu, tim produksi justru terpaksa menghabiskan tiga jam tambahan hanya untuk membedah ulang rekaman demi memperbaiki naskah yang berantakan.
Situasi frustrasi ini dialami oleh ribuan kreator, produser podcast, dan tim pemasaran konten di Indonesia. Di atas kertas, teknologi pengenalan suara otomatis (Automatic Speech Recognition atau ASR) menjanjikan efisiensi luar biasa. Namun saat dihadapkan pada realitas percakapan bahasa Indonesia sehari-hari, sebagian besar sistem transkripsi berbasis kecerdasan buatan masih menghasilkan tingkat kesalahan kata (Word Error Rate atau WER) yang cukup tinggi.
Untuk mengatasi inefisiensi ini secara permanen, kita perlu memahami secara mendalam faktor struktural di balik kegagalan tersebut dan menerapkan alur kerja yang terstandarisasi dari hulu ke hilir.
Akar Masalah: Mengapa Transkripsi Audio Bahasa Indonesia Kerap Gagal
Kegagalan mesin transkripsi dalam menangkap percakapan bahasa Indonesia bukan semata-mata karena model komputasi yang belum matang, melainkan karena keunikan linguistik dan kebiasaan bertutur masyarakat kita yang sangat kompleks.
1. Fenomena Code-Mixing dan Kosakata Pinjaman (Indoglish)
Dalam podcast bisnis, teknologi, atau gaya hidup, pembicara sangat jarang berbicara dalam bahasa Indonesia baku seratus persen. Mereka secara alamiah menyisipkan istilah asing: "Kita perlu pivot strategi go-to-market sebelum runway menipis." Engine ASR konvensional yang disetel untuk model bahasa tunggal (monolingual) akan mengalami kebingungan fonetik. Kata "runway" kerap kali diubah menjadi "ranwei" atau "rantai", sementara "pivot" berubah menjadi "pispot" atau "lewat". Ketidakmampuan mengenali batas antarkata dalam pergantian kode bahasa (code-switching) ini menjadi penyumbang terbesar distorsi makna.
2. Partikel Percakapan dan Ragam Bahasa Lisan
Bahasa Indonesia lisan memiliki kesenjangan sangat lebar dengan bahasa Indonesia tulisan formal standar KBBI. Penutur asli menggunakan partikel penegas, modalitas, dan kata tugas non-baku seperti "sih", "deh", "lho", "kan", "nggak", "beneran", hingga "gimana". Sebagian besar corpus data latih pada model ASR global didominasi oleh teks berita resmi atau naskah parlemen yang kaku. Akibatnya, saat menghadapi aliran percakapan santai, sistem kesulitan mendeteksi intonasi kalimat tanya, penekanan emosional, dan batas antarkalimat, sehingga tanda baca yang dihasilkan menjadi acak-acakan.
3. Masalah Akustik Ruangan dan Rasio Sinyal terhadap Derau (SNR)
Banyak rekaman audio podcast diproduksi di ruang kerja biasa atau kamar tanpa peredam suara memadai. Pantulan suara dinding (reverberation), suara pendingin ruangan (AC), desis kipas laptop, hingga dengung listrik frekuensi rendah menurunkan Signal-to-Noise Ratio (SNR). Ketika sinyal vokal tenggelam atau terdistorsi oleh noise floor, model akustik kehilangan ketajaman dalam membedakan konsonan letup (plosive) dan desis (fricative), misalnya membedakan antara huruf /p/ dan /b/, atau /t/ dan /d/.
4. Overlapping Speech dan Minimnya Pemisahan Pembicara
Pada sesi podcast yang dinamis, interupsi, tawa bersamaan, dan tanggapan cepat (cross-talk) tidak terhindarkan. Mesin transkripsi sederhana tanpa kapabilitas speaker diarization tingkat lanjut akan mencampuradukkan ucapan kedua partisipan menjadi satu paragraf raksasa. Kalimat host dan narasumber bertumpuk tanpa atribut subjek yang jelas, melipatgandakan waktu penyuntingan manual.
Kerangka Kerja 3P: Strategi Menjamin Akurasi Transkrip
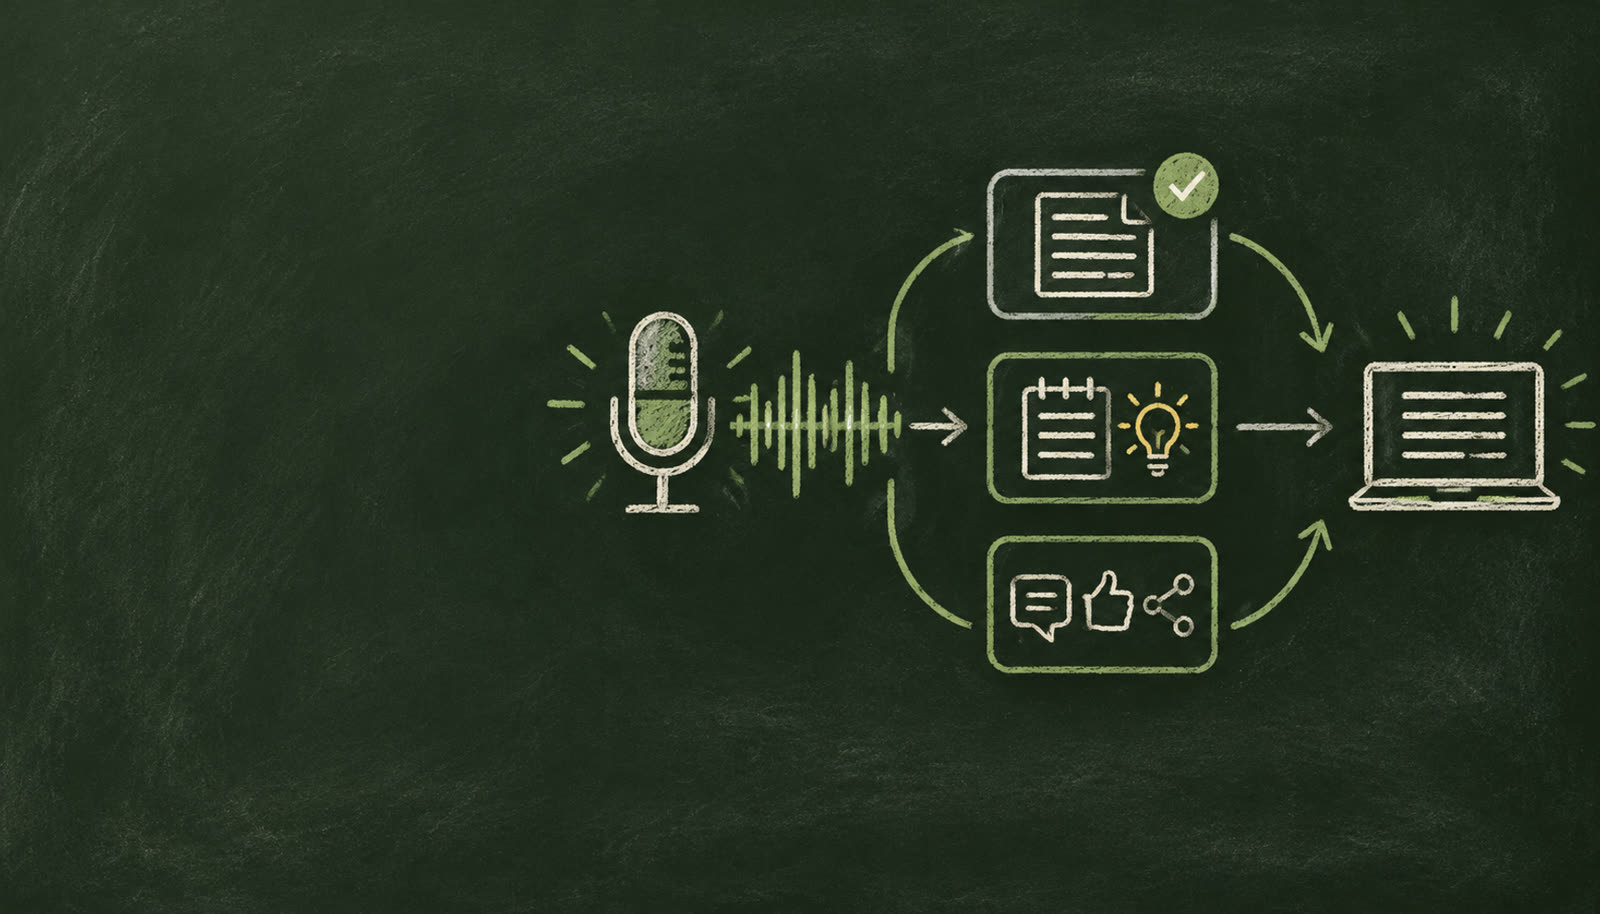
Untuk menghasilkan transkrip yang bersih, akurat, dan siap diolah menjadi aset turunan, Anda membutuhkan pendekatan sistematis yang disebut Kerangka Kerja 3P: Pre-capture, Processing, dan Post-editing.
Pilar 1: Pre-Capture Fidelity (Kualitas Masukan Audio)
Kualitas teks hasil transkripsi bergantung sepenuhnya pada prinsip dasar pengolahan data: kualitas masukan menentukan kualitas keluaran. Mengandalkan rekaman mikrofon bawaan laptop atau file audio kompresi rendah dari panggilan konferensi daring adalah jaminan pasti rusaknya akurasi teks. Rekaman harus menggunakan mikrofon terpisah dengan pola tangkapan terarah (cardioid), mempertahankan jarak mulut sekitar 10 hingga 15 sentimeter, serta direkam dalam format audio tanpa kompresi destruktif (minimal 44.1 kHz, 16-bit WAV atau FLAC).
Pilar 2: Processing Intelligence (Pemilihan Model dan Diarization)
Tahap pemrosesan membutuhkan teknologi yang tepat sasaran. Model ASR yang digunakan wajib memiliki penyesuaian khusus terhadap aksen lokal, fleksibilitas terhadap kosakata dwibahasa, serta arsitektur deep learning yang mampu mengeksekusi speaker diarization secara akurat. Pemrosesan ini harus mampu memisahkan trek pembicara berdasarkan sidik suara unik (voiceprint), menandai cap waktu (timestamp) dengan presisi milidetik, dan menyisipkan tanda baca semantik secara otomatis.
Pilar 3: Post-Processing & Semantic Structuring (Penyempurnaan Struktur Teks)
Transkrip mentah yang akurat sekalipun tetap membutuhkan sentuhan akhir sebelum dapat dibaca dengan nyaman oleh audiens. Pilar ini mencakup penghapusan kata jeda nirguna (filler words seperti "umm", "ngg", "apa namanya"), koreksi kapitalisasi pada nama brand atau entitas khusus, serta segmentasi paragraf berdasarkan pergantian ide pokok pembicaraan, bukan sekadar jeda napas sesaat.
Panduan Langkah Demi Langkah: Alur Kerja dari Rekaman Kasar ke Teks Siap Pakai
Berikut adalah panduan taktis yang dapat diterapkan langsung oleh tim produksi Anda untuk mentransformasikan file rekaman podcast menjadi teks yang terstruktur rapi:
Langkah 1: Isolasi Kanal dan Optimasi File Master
Jangan pernah menggabungkan vokal beberapa narasumber ke dalam satu trek tunggal (single mono/stereo mix) saat proses perekaman berlangsung. Gunakan pengaturan perekaman multi-trek lokal (double-ender recording) di mana setiap pembicara memiliki trek audionya masing-masing. Sebelum memasukkan audio ke mesin transkripsi, lakukan langkah pembersihan ringan: potong frekuensi di bawah 80 Hz menggunakan high-pass filter untuk menghilangkan dengung meja, lalu terapkan noise gate lembut untuk membungkam kebocoran suara latar saat pembicara sedang diam.
Langkah 2: Eksekusi Transkripsi dengan Konfigurasi Konteks Khusus
Saat memasukkan file audio ke sistem ASR, sediakan panduan konteks atau daftar kata kunci (custom vocabulary/glossary). Masukkan nama narasumber, nama perusahaan, jargon industri, dan istilah teknis yang sering muncul dalam episode tersebut. Tindakan sederhana ini memberi bobot probabilitas lebih tinggi pada model bahasa untuk memilih kata yang benar ketika dihadapkan pada ketidakpastian fonetik. Pastikan fitur penandaan pembicara (speaker labels) aktif dengan jumlah partisipan yang telah ditentukan secara eksplisit.
Langkah 3: Kurasi Berbasis Makna dan Pembentukan Struktur Konten
Setelah draf transkrip selesai dibuat, hindari membaca ulang kata demi kata sambil mendengarkan seluruh durasi rekaman dari awal. Lakukan kurasi berbasis pemindaian cepat (skim reading):
- Pembersihan Filler Words: Hapus kata pengisi yang tidak memiliki kontribusi informasi tanpa mengubah gaya alami penutur.
- Standardisasi Entitas Bisnis: Gunakan fungsi pencarian dan penggantian (find and replace) global untuk memastikan penulisan merek, singkatan, dan istilah seragam.
- Pemberian Heading Konseptual: Kelompokkan percakapan panjang ke dalam subbab-subbab tematik agar alur pemikiran mudah dipetakan saat teks hendak dialihfungsikan menjadi artikel blog atau media sosial.
Matriks Keputusan: Perbandingan Metode Transkripsi Audio ke Teks
Memilih metode pengolahan audio ke teks harus disesuaikan dengan kapasitas tim, kecepatan kerja, dan anggaran operasional. Tabel berikut menyajikan perbandingan objektif antara tiga pendekatan umum di industri:
| Parameter Evaluasi | Transkripsi Manual (Transkriber Manusia) | ASR Generik Global (Model Standar) | Platform AI Terintegrasi (Podlyzer) |
|---|---|---|---|
| Kecepatan Penyelesaian | Lambat (4-6 jam per 1 jam audio) | Sangat Cepat (5-10 menit per 1 jam audio) | Sangat Cepat (3-7 menit per 1 jam audio) |
| Biaya Operasional | Tinggi (Rp150.000 - Rp400.000 per jam audio) | Rendah (berdasarkan durasi komputasi) | Terjangkau (model langganan SaaS berbasis nilai) |
| Akurasi Percakapan Indonesia | Sangat Tinggi (memahami konteks lokal) | Sedang hingga Rendah (sering salah pada Indoglish) | Tinggi (dioptimalkan untuk dialek dan istilah bisnis) |
| Deteksi Pembicara (Diarization) | Sempurna (dilakukan secara manual) | Sering Terbalik atau Melebur | Otomatis dan Terisolasi Akurat per Pembicara |
| Kebutuhan Koreksi Manual | Minimal (hanya pengecekan akhir) | Sangat Tinggi (membutuhkan restrukturisasi ulang) | Rendah (teks sudah bersih dan terstruktur) |
| Kesiapan Turunan Konten | Tidak Ada (hanya menghasilkan dokumen teks mentah) | Tidak Ada (harus disalin dan diolah manual) | Instan (otomatis dikonversi ke 15 format aset konten) |
Melalui matriks di atas, tampak jelas bahwa mengandalkan transkripsi manual murni memakan waktu dan biaya besar, sedangkan ASR generik global menuntut beban kerja pascaproduksi yang melelahkan. Solusi terbaik bagi tim konten modern adalah platform yang mengawinkan kecepatan transkripsi cerdas dengan kesiapan repurposing instan.
Mengotomasi Alur Transkripsi dan Repurposing Konten dengan Podlyzer
Bagi tim konten yang memproduksi episode secara rutin, transkrip hanyalah batu loncatan awal. Tujuan akhir dari rekaman podcast adalah mendistribusikan wawasan pembicara ke sebanyak mungkin saluran digital untuk memperluas jangkauan audiens dan mendorong pertumbuhan organik.
Di sinilah peran platform terpadu seperti Podlyzer menjadi pembeda signifikan. Podlyzer tidak hanya menjalankan proses transkripsi otomatis dengan akurasi tinggi pada audio berbahasa Indonesia dan memisahkan dialog antarpembicara secara rapi melalui teknologi speaker diarization mutakhir, tetapi juga menghilangkan gesekan kerja pascaproduksi secara menyeluruh.
Alih-alih membiarkan transkrip Anda membeku di dalam file teks yang tidak terjamah, mesin cerdas Podlyzer langsung mengekstrak ide-ide kunci rekaman dan mengonversinya menjadi 15 format aset konten turunan dalam sekejap. Tanpa perlu menyusun perintah berbelit-belit ke berbagai aplikasi terpisah, Anda dapat langsung memperoleh:
- Artikel blog berbobot dengan optimasi SEO yang mendalam.
- Edisi newsletter mingguan yang renyah untuk para pelanggan email.
- Rangkaian posting pemikiran (thought leadership) siap tayang di LinkedIn.
- Utas mendalam (thread) untuk platform X yang memancing interaksi.
- Ringkasan konsep edukatif dalam format carousel visual.
- Catatan episode (show notes) lengkap dengan stempel waktu dan kutipan penting.
Dengan menghilangkan pekerjaan repetitif merapikan transkrip manual, tim produksi dapat mengalihkan fokus dan energi kreatif mereka untuk merancang topik yang lebih berbobot, mewawancarai narasumber yang lebih berbobot, serta memperkuat strategi distribusi konten.
Kesimpulan dan Rangkuman Aksi untuk Tim Konten
Transkrip audio ke teks bahasa Indonesia yang berantakan bukanlah takdir yang harus diterima begitu saja. Sebagian besar kekacauan teks disebabkan oleh kombinasi kualitas akustik rekaman yang terabaikan, pemaksaan model bahasa yang tidak mengenal ragam percakapan lokal, dan ketiadaan alur kerja pascaproduksi yang efisien.
Gunakan checklist praktis berikut ini sebagai standar operasional prosedur pada sesi rekaman dan produksi konten Anda berikutnya:
- Gunakan Mikrofon Terarah dan Rekam Terpisah: Pastikan setiap pembicara terekam dalam jalur audio terisolasi untuk memudahkan pemisahan suara.
- Kendalikan Akustik Ruangan: Redam pantulan suara menggunakan karpet, tirai tebal, atau panel busa, serta jaga jarak mikrofon secara konsisten.
- Pilih Engine yang Mendukung Konteks Lokal: Pastikan sistem transkripsi yang Anda gunakan mampu menangani istilah bilingual dan slang percakapan modern.
- Terapkan Otomatisasi Alur Kerja: Jangan berhenti pada file transkrip mentah. Integrasikan alat otomatisasi yang dapat mengubah rekaman audio menjadi berbagai format konten siap publikasi secara konsisten.
Ketika fondasi teknis dan alur kerja cerdas telah terpasang rapi, rekaman audio Anda tidak lagi menjadi beban penyuntingan, melainkan aset paling berharga untuk mendominasi lanskap konten digital.
Pertanyaan yang sering diajukan
Mengapa speech-to-text bahasa Indonesia sering salah mengenali istilah asing atau Indoglish?
Model Automatic Speech Recognition (ASR) konvensional umumnya dilatih dengan korpus monolingual. Ketika pembicara beralih kode bahasa (code-switching) secara cepat di tengah kalimat, model kesulitan memetakan fonem asing ke dalam leksikon bahasa Indonesia. Untuk mengatasinya, gunakan platform yang mendukung model multilingual atau sediakan daftar kosakata khusus (custom vocabulary) sebelum proses transkripsi berjalan.
Seberapa krusial peran mikrofon dan akustik ruangan terhadap akurasi transkrip?
Sangat krusial. Akurasi transkripsi otomatis bergantung langsung pada rasio sinyal terhadap derau (Signal-to-Noise Ratio atau SNR). Mikrofon terarah seperti tipe dynamic cardioid yang diletakkan dekat dengan sumber suara mampu meredam pantulan gema ruangan dan desis latar belakang. Semakin bersih sinyal vokal mentah yang ditangkap, semakin rendah tingkat kesalahan kata (Word Error Rate) yang dihasilkan sistem AI.
Apakah hasil transkrip otomatis bisa langsung dipublikasikan sebagai artikel blog?
Tidak disarankan. Bahasa lisan memiliki struktur yang berbeda dengan bahasa tulisan; percakapan spontan memuat banyak pengulangan ide, partikel non-baku, dan alur asosiatif yang melelahkan jika dibaca langsung. Transkrip mentah perlu melalui rekonstruksi semantik atau diproses menggunakan generator konten berbasis AI seperti Podlyzer yang mampu merestrukturisasi intisari dialog menjadi artikel teroptimasi SEO.